
阿喵前言
想弄懂一个中文大模型是怎么从语料、分词器一路训练到后训练和评测的,只看架构图,真能串起整个过程吗?tinybrain 把数据处理、训练脚本、推理与评测放进一个能逐段阅读的开源项目,适合想顺着代码研究小模型训练链路的开发者;它目前更像一份可运行的学习工程,还不是拿来即用的聊天模型。
资源介绍
tinybrain 是一个采用 MIT 许可、免费开源的中文模型训练项目,包含自建分词器、预训练语料处理、预训练、SFT、蒸馏、强化学习、评测和本地推理。作者整理了多档中文数据,并围绕古文、诗词等内容做了专门配比。项目链路已在小型演示模型上跑通,但训练中的正式权重尚未发布,因此下载源码不等于获得可直接聊天的成品模型。
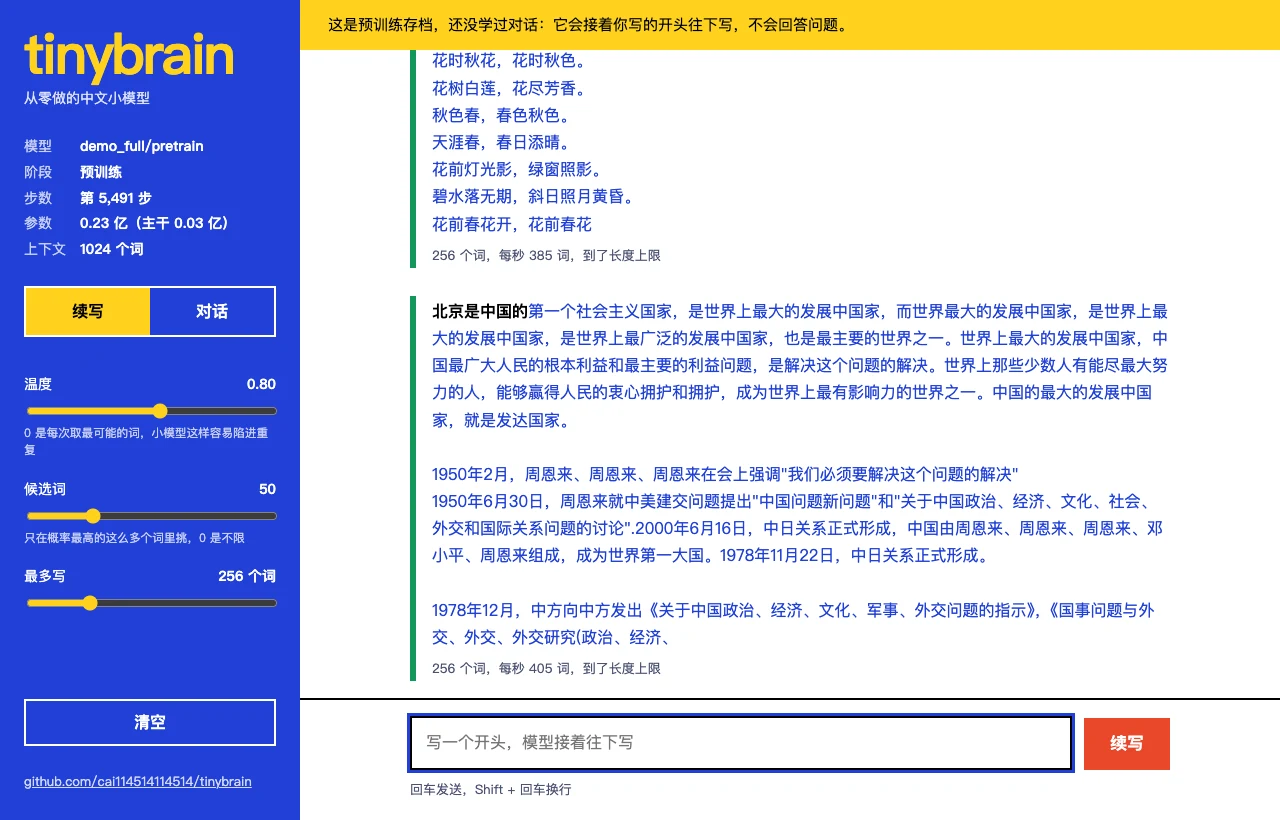
截图:预训练模型演示界面
特色
- 数据清洗、去重、分档及训练过程均有代码可读。
- 覆盖预训练、SFT、蒸馏、强化学习和评测等阶段。
- 提供命令行推理、聊天网页和小型演示流程,便于逐步理解工程组织。
- 中文语料与分词器是项目重点,也包含古文和诗词相关数据。
注意
- 需要 Python 3.11+、PyTorch 2.5+;实际训练还需合适的 GPU、存储与较长运行时间。
- 数据集、训练代码可供研究,正式训练权重目前未发布;不要把演示模型当作已完成的通用聊天模型。
- 运行训练会下载并处理较大数据,所需算力和时间取决于数据档位与硬件。
使用教程
- 克隆 GitHub 仓库并阅读 README 的环境与许可说明。
- 准备 Python、PyTorch 和所需数据;先用数据检查命令查看缺少的输入文件。
- 按 README 的快速开始运行小规模预训练与 SFT,数据和输出目录先留足空间。
- 用内置 demo 或 serve 查看小模型输出;不要把 2300 万参数演示模型的表现等同于正式权重。
- 想继续研究时,再沿 README 的完整流程查看退火、强化学习和评测步骤。