一句话介绍:Voice-Pro 将语音识别、人声分离、翻译、文字转语音和语音克隆集中到一个网页界面,适合制作字幕、视频配音和多语言内容。
阿喵前言
给视频做一套外语配音,往往需要来回切换几个工具:提取音频、识别字幕、翻译文本,再生成新的语音。
Voice-Pro 把这些环节放进了同一个工作台。部署到自己的电脑后,通过浏览器就能操作,适合想自己掌控音频处理流程的用户。
资源介绍
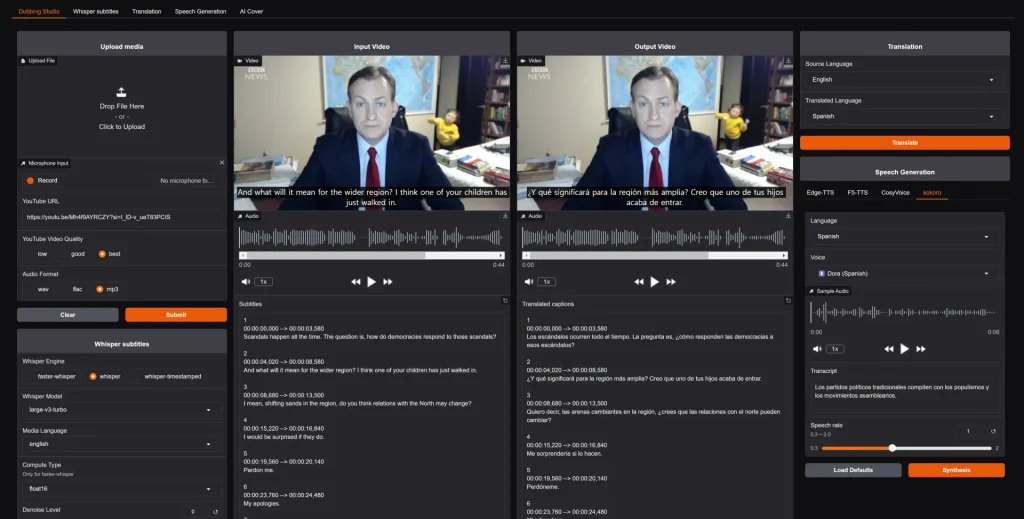
Voice-Pro 是基于 Gradio 的开源语音处理应用。它整合 Whisper、Demucs、Edge-TTS、kokoro,以及 F5-TTS、E2-TTS、CosyVoice 等工具,覆盖从音视频处理到语音生成的常见需求。项目介绍
例如,处理一段采访视频时,可以先分离人声、识别字幕,校对并翻译文本后,再生成目标语言的配音。最终效果仍需要试听和调整,尤其是人名、专业术语及语气。
截图
特色
- Whisper 系列模型识别语音、生成字幕
- Demucs 分离人声与背景音乐
- 支持字幕翻译和实时语音翻译
- Edge-TTS、kokoro 将文字转换为语音
- F5-TTS、E2-TTS、CosyVoice 支持零样本语音克隆
- 集成 YouTube 下载及音频提取
- 浏览器界面操作,可在本机部署
以上功能的语言覆盖范围因模型和服务而异,并非每个语音模型都支持全部语言。功能说明
注意
- 本地部署不等于完全离线:Edge-TTS、默认翻译服务及在线视频下载需要联网。
- 官方明确验证的是 Windows+NVIDIA 显卡环境,Mac 和 Linux 的运行情况尚未验证。
- 首次运行需要下载依赖和模型,建议预留至少 20GB 空间;官方列出的显存要求为 4GB 起,优先考虑 8GB 以上。
- README 仍保留暂缓更新的公告,使用前建议查看近期提交和 Issues。
- 克隆声音应使用本人或获得授权的录音;商用前还需核对所用模型的许可。
部署条件和联网服务说明可见官方 README。
教程
以 Windows 为例:
- 打开 GitHub 仓库,点击 Code → Download ZIP,下载并解压源码。
- 运行
start.bat,等待安装环境和下载模型。首次启动时间取决于网络速度。 - 浏览器打开后进入操作界面;若没有自动打开,可访问启动窗口显示的本地地址。
- 制作字幕时选择 Whisper Caption,导入素材并设置识别语言。
- 翻译字幕使用 Translate;生成配音或克隆声音使用 Speech Generation。
- 先用短素材测试,校对字幕并试听语音,再处理完整内容。
当前安装说明允许跳过需要管理员权限的 configure.bat,直接由 start.bat 准备运行环境。安装教程

感谢分享,正好需要本地部署的语音工具,先收藏了!