一句话介绍:yovoice 是一款适用于 macOS 和 Windows 的开源声音创作工具,支持本地文字转语音、音色克隆和情绪调整,无需调用云端 API,也没有按字数计费的开销。
阿喵前言
做视频旁白、故事配音或有声内容时,文字转语音只是第一步。想让声音符合角色,还得调整音色、语气和情绪,反复试听。
yovoice 把这些操作集中到一个创作工作台里。模型下载到电脑后,就能在本地生成语音,适合需要经常修改文稿、尝试不同声音的用户。
资源介绍
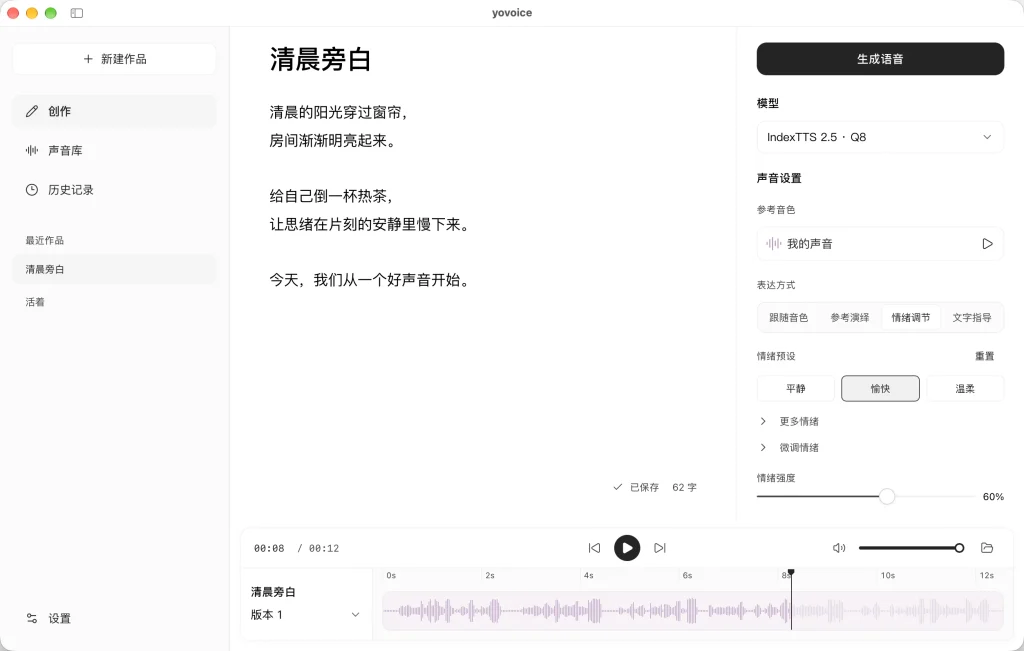
yovoice 支持输入文字或导入字幕,并围绕角色组织配音作品。参考音频可以直接导入或录制,再进行裁剪、生成、试听和导出,形成一套完整的音频创作流程。
它提供多种模型选择,包括 IndexTTS、VoxCPM2、OmniVoice、Qwen3-TTS 和 Kokoro。不同模型各有侧重:有的擅长参考音色克隆,有的支持情绪控制,也有的可以直接根据文字描述设计声音。
中文、英语、日语等语言的支持范围取决于所选模型。例如 IndexTTS 2.0 主要支持中英,2.5 则增加了日语等语言。
截图
特色
- 本地文字转语音,无按字数计费
- 支持参考音色克隆和演绎模仿
- 可用情绪设置或文字描述调整表达
- 部分模型支持无需参考录音的声音设计
- 支持参考音频录制、导入和裁剪
- 提供故事配音、试听与作品导出
- 支持模型下载续传和 GGUF 导入
- 提供 CLI 与 Agent Skill,可交给 AI Agent 完成配音
硬件方面,Apple Silicon 支持 Metal 加速;Windows 支持 CPU、NVIDIA CUDA 和实验性 Vulkan。
注意
- macOS 安装包面向 macOS 14 及以上的 Apple Silicon 设备;Windows 面向 Windows 10/11 x64。
- 首次下载模型需要联网,生成速度取决于硬件和模型大小。
- 并非所有模型都支持声音克隆、情绪控制或全部语言。
- 程序开源许可与模型许可分别适用;OmniVoice 权重仅限非商业用途。
- 克隆声音应使用本人或获得授权的录音。
- 建议先用短文本试听,确认发音和语气后再生成长篇内容。
使用教程
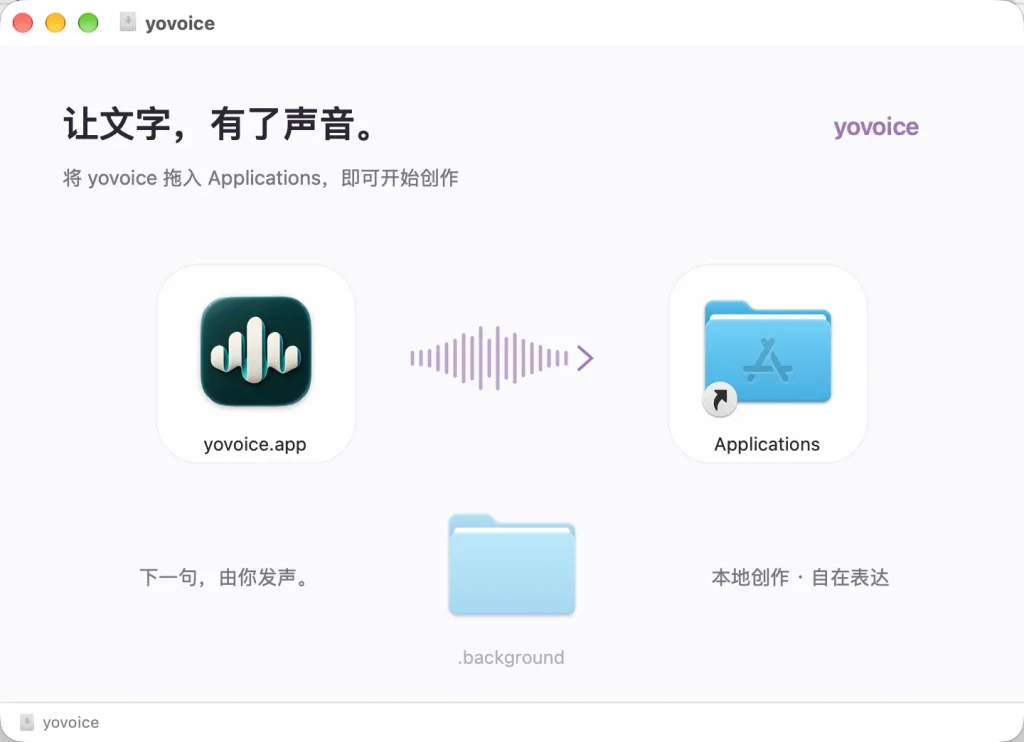
- 前往 GitHub Releases,下载对应平台的安装包。
- macOS 打开
.dmg,将应用拖入“应用程序”;Windows 运行-setup.exe。 - 启动后进入设置,下载需要的语音模型。
- 新建作品,选择“故事配音”或“语音生成”。
- 输入文字或导入字幕,选择角色并设置声音;需要克隆时,添加参考录音。
- 点击“生成语音”,试听并调整,满意后导出作品。
如果希望由 AI Agent 根据文稿和参考录音完成配音,也可以使用项目提供的 yovoice Skill,通过独立 CLI 运行,无需打开桌面应用。

这个工具看起来很实用,本地运行还支持声音克隆,正好需要做视频旁白,回去试试 macOS 版本。