
阿喵前言
翻一份外文资料,为什么还要在 PDF、表格、截图和翻译网页之间来回折腾?阿喵这次找到的万能翻译站,把这些入口收进了同一个 Windows 窗口:拖入文件或整个文件夹,提取文字、批量翻译,再逐条修改并导出。平时要看外文文档,偶尔处理图片或游戏剧本的朋友,可以少做不少复制粘贴。
资源介绍
万能翻译站(Universal Translator)是一款免费、MIT 开源的 Windows 桌面翻译工具。当前 v1.4.1 提供含 OCR 的独立 EXE,支持 Word、Excel、PPT、EPUB、PDF、HTML、Markdown 和 TXT,也能批量识别图片文字。
它把导入、提取、翻译、校对和导出串在一起,适合整理外文资料、阅读笔记或处理可编辑的游戏文本。译文可以逐条修改,再按用途保存为原格式、文本、Word 或 PDF;翻译引擎支持 MyMemory、百度、DeepL 及 OpenAI 兼容接口。
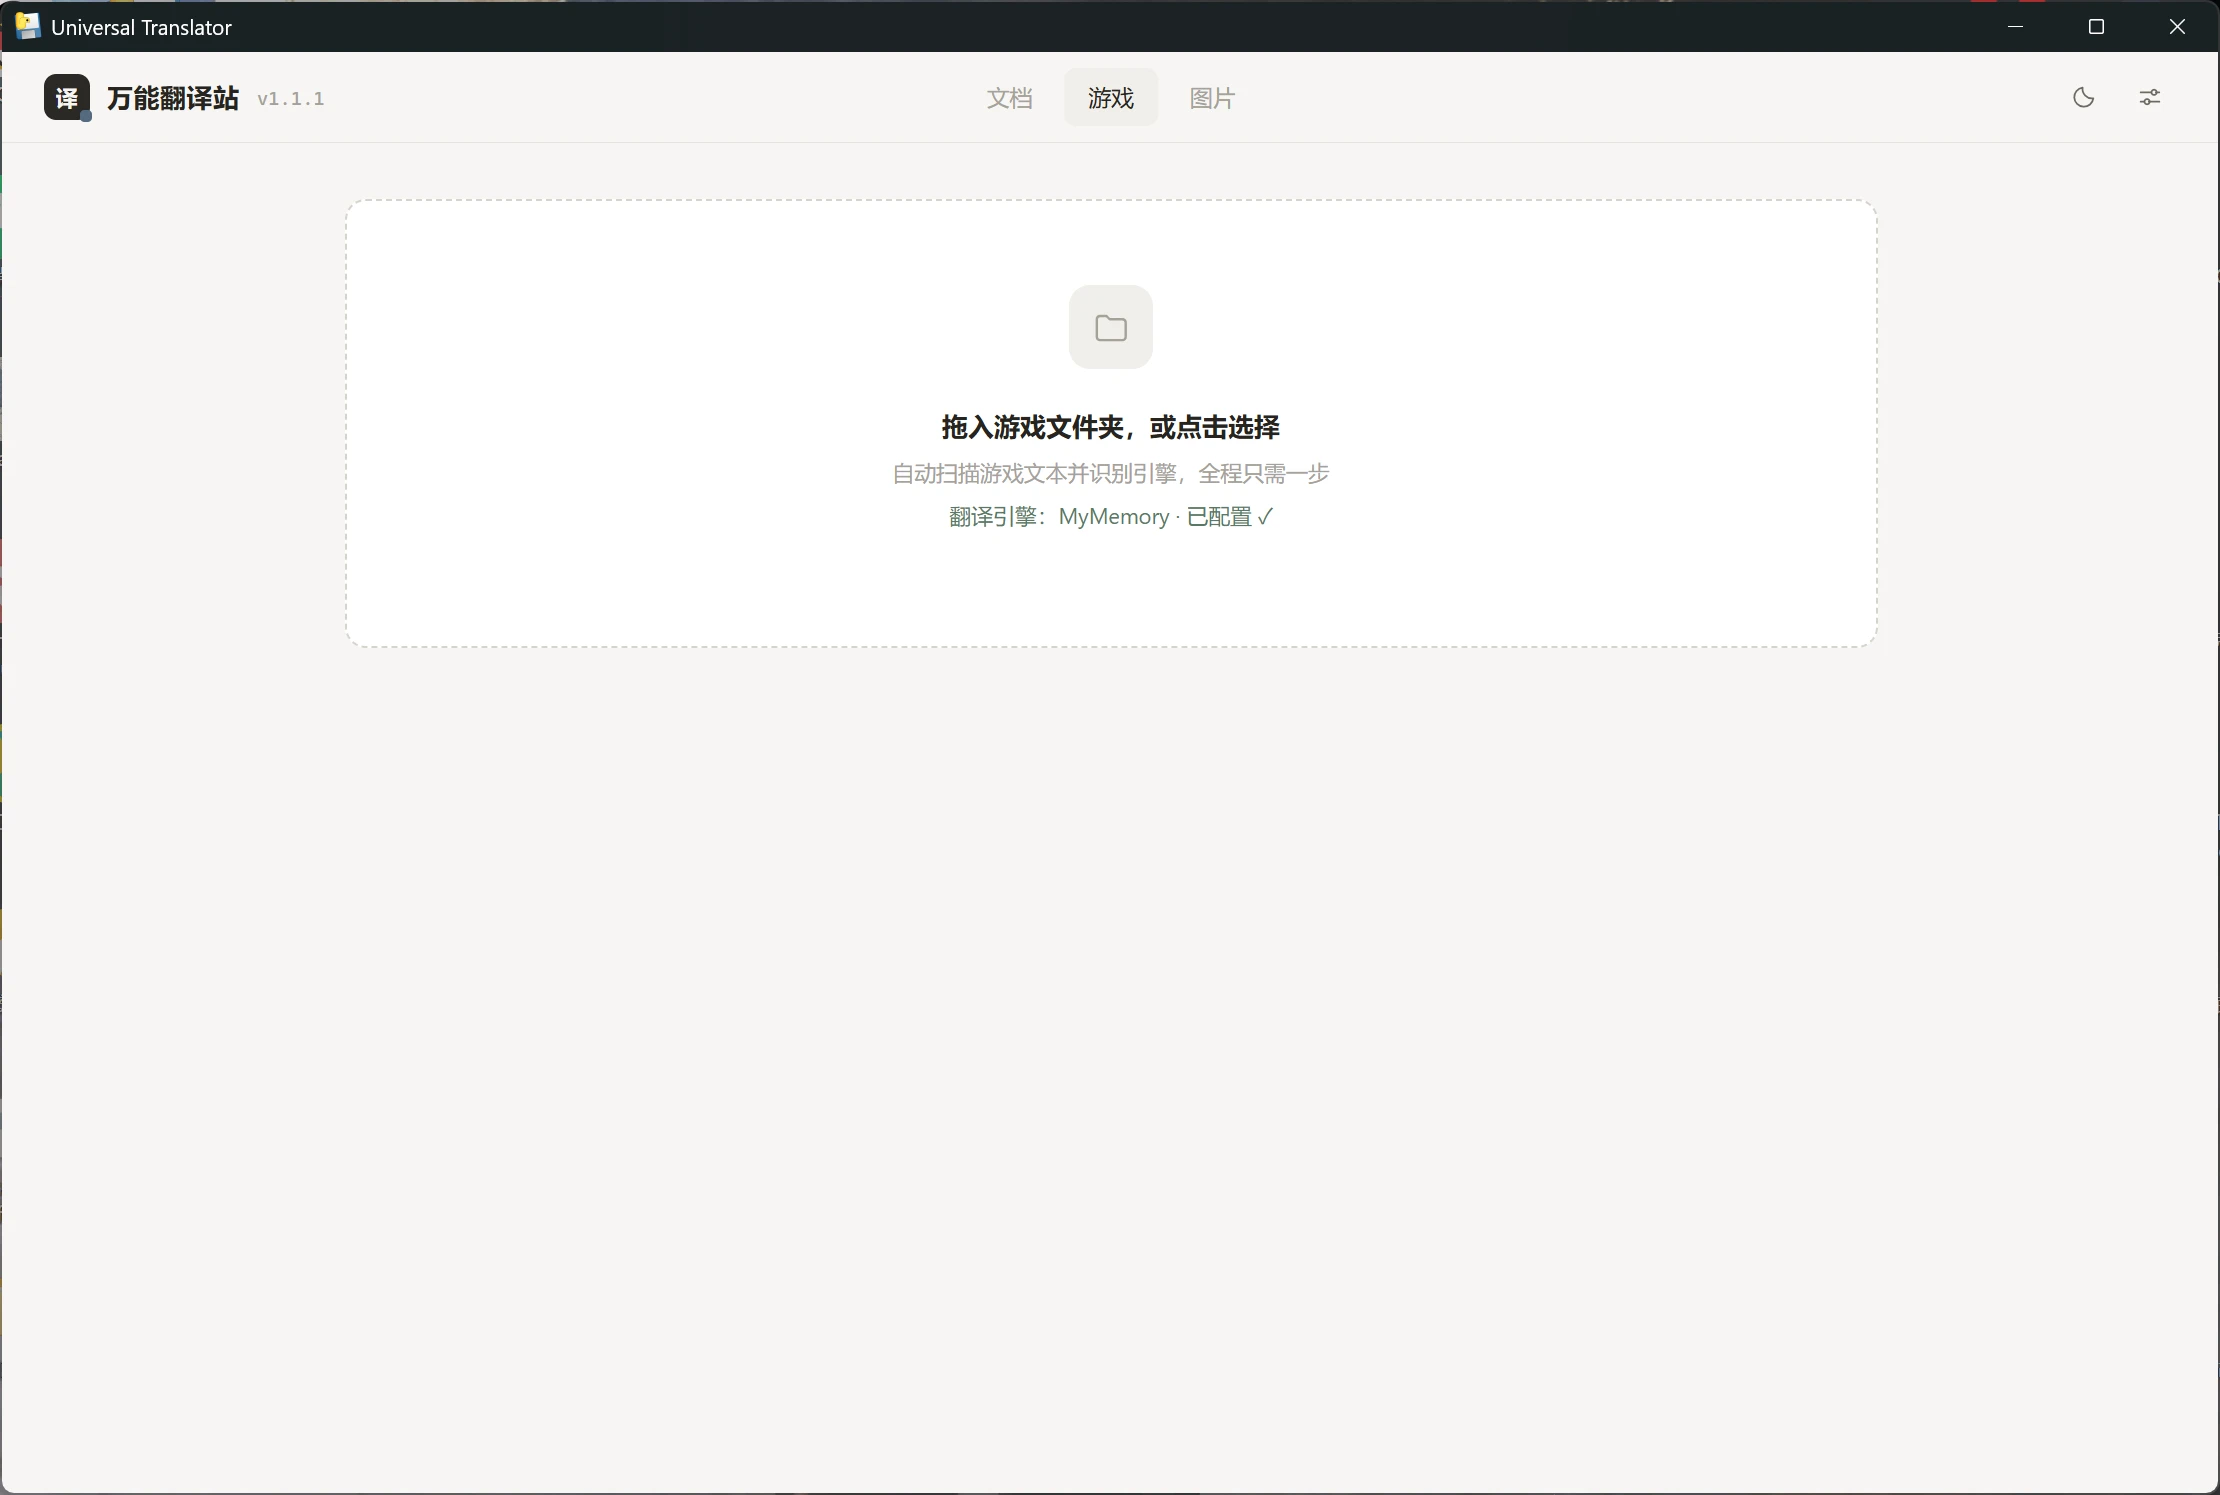
截图
特色
- 文件夹整批导入:递归扫描子目录,同名文档用相对路径区分,省去逐个打开的麻烦。
- PDF 与图片 OCR:文字型 PDF 直接提取,扫描件自动识别;图片支持 PNG、JPG、WebP 和 BMP。
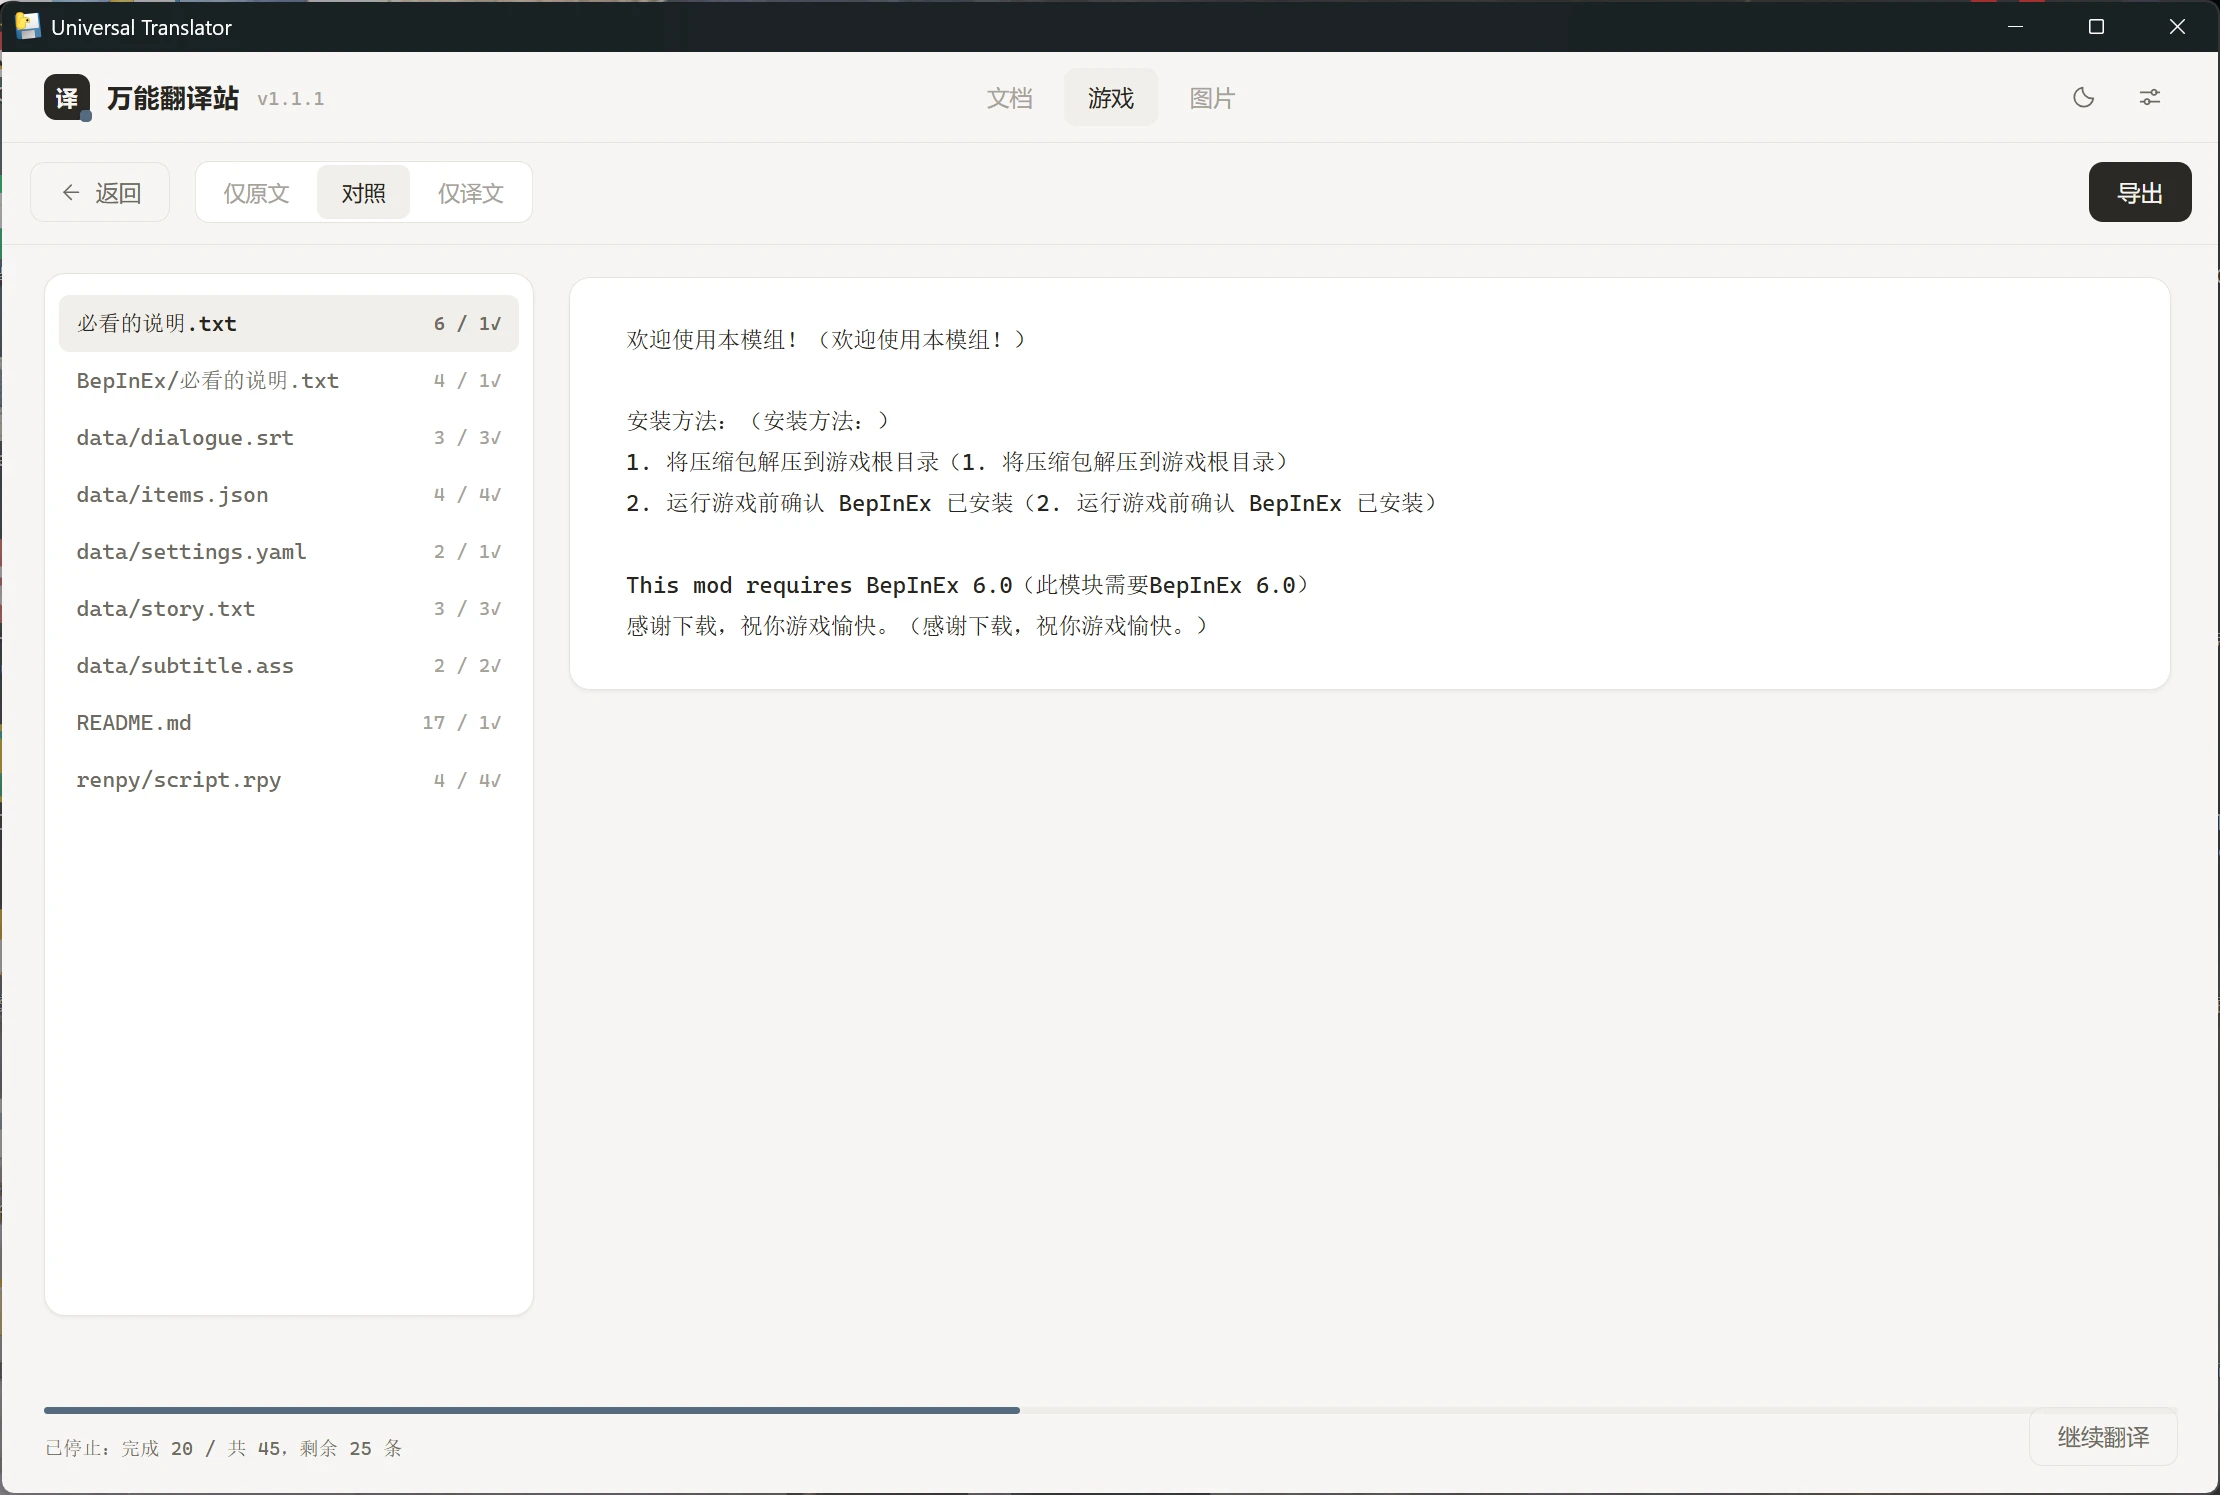
- 边看边改:在原文、对照、译文视图之间切换,直接校正条目,导出使用修改后的内容。
- 导出方式可组合:选择格式后,可逐个保存到文件夹,也可打包 ZIP;图片译文还能导出覆盖图。
- 兼顾游戏剧本:识别 Ren’Py 的 RPY、吉里吉里的 KS,提供未加密 XP3 的解包、翻译和重新封包入口。
注意
- 现成安装包面向 Windows 10/11,包含 OCR,无需另装 Python;暂未提供 macOS 或 Linux 安装包。自行跑源码还需准备 PyMuPDF、python-docx、pywebview,OCR 依赖 RapidOCR。
- 软件本身免费。MyMemory 免配置但有每日额度,百度和 DeepL 需要对应密钥,额度与收费按服务规则;云端接口会收到待译文本。使用本地模型需自行准备 Ollama、LM Studio 等兼容服务及相应硬件。
- 保留文件结构不等于排版完全不变:译文长度、字体和复杂表格仍需校对,跨格式转换只保留文字。文档提取会过滤超过 800 字符的单个文本单元,长段落或长行建议拆分后检查有无遗漏。
- 游戏资源处理仅用于自制或获授权文件。加密 XP3、Unity/UE 资源包及程序内嵌字符串不在当前支持范围内,导出后还要检查编码与字体显示。
使用教程
- 下载并打开。从文末官方 v1.4.1 发行页获取 UniversalTranslator-v1.4.1.exe,放在便于管理的位置运行。
- 先设置语言与引擎。在右上角设置中选择目标语言;少量资料可先用 MyMemory,需要其他服务时填写对应配置。选本地模型时,填入兼容接口地址和模型名。
- 导入要翻译的内容。文档页拖入 DOCX、XLSX、PPTX、EPUB、PDF、HTML、MD、TXT 或整个文件夹;图片页导入图片后先勾选再 OCR。扫描版 PDF 会自动走 OCR,文字层乱码时可切换“图片 OCR”重新提取。
- 翻译后逐条校对。检查扫描出的文件和文本,开始翻译,再切换对照视图核对术语、数字与漏译内容;需要时启用编辑,直接修改原文或译文。
- 按目标选择导出。DOCX、XLSX、PPTX、EPUB 等选择“原格式”可写回对应文件结构;也可导出 TXT、Markdown、HTML、Word 或 PDF。再选择逐个保存到文件夹或打包 ZIP,通过系统对话框选位置。
PDF 这里要单独留意:v1.4.1 的 PDF 源文件选择“原格式”实际生成 Word;想保留 PDF 页面布局,请明确选择“PDF”。文字型 PDF 会擦除原文字并在对应位置写入译文,扫描件则以页面图为底覆盖译文,导出后重点检查长译文、密集表格与多栏内容。其他格式转成 PDF 会按文字重新排版。
资源获取
当前版本:v1.4.1;文件名:UniversalTranslator-v1.4.1.exe;系统:Windows 10/11。下载入口见下方资源卡片。